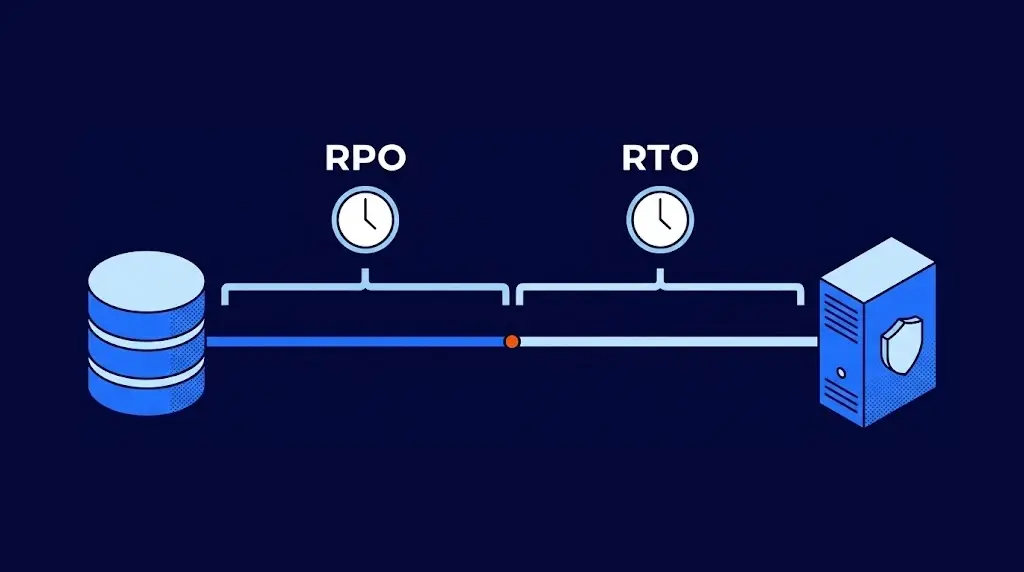
El RTO (Recovery Time Objective, objetivo de tiempo de recuperación) es el tiempo máximo que un sistema puede estar detenido después de una falla antes de que el daño al negocio sea inaceptable. El RPO (Recovery Point Objective, objetivo de punto de recuperación) es la cantidad máxima de información que la empresa acepta perder, medida en tiempo hacia atrás desde la falla hasta la última copia buena. El primero responde "¿en cuánto tiempo volvemos?" y el segundo "¿hasta qué momento recuperamos los datos?".
Los dos se fijan sistema por sistema y deciden cuánto cuesta la recuperación: bajar un RTO de un día a una hora, o un RPO de 24 horas a unos minutos, cambia por completo la tecnología que necesitas y su precio.
Qué son el RTO y el RPO
Quien ha jugado un videojuego conoce la escena: se apaga la consola y, al volver, el juego arranca desde el último punto de guardado. Todo lo que avanzaste después de guardar se perdió; eso es el RPO. Y el tiempo que tardas en cargar la partida y volver a donde ibas es el RTO. Guardar cada cinco minutos reduce lo que pierdes; tener la consola lista para encender rápido reduce lo que esperas.
En una empresa, la secuencia de un incidente se ve así:
| Momento | Qué pasa | Qué mide |
|---|---|---|
| Última copia buena | El respaldo o la réplica más reciente que no está dañada. | Aquí empieza a contar el RPO. |
| Falla | El sistema se detiene: un servidor que no enciende, un cifrado, un error humano. | Aquí termina el RPO y empieza el RTO. |
| Operación de vuelta | El sistema funciona otra vez y las áreas pueden trabajar. | Aquí termina el RTO. |
Por eso el RTO y el RPO son objetivos y no resultados: son las metas que la empresa se pone antes de que algo falle.
Diferencia entre RTO y RPO
Se mencionan juntos, pero miden cosas distintas y se resuelven con herramientas distintas:
| Aspecto | RTO | RPO |
|---|---|---|
| Pregunta que responde | ¿Cuánto tiempo puede estar detenido el sistema? | ¿Cuánta información podemos perder? |
| Hacia dónde mira | Hacia adelante: desde la falla hasta volver a operar. | Hacia atrás: desde la falla hasta la última copia. |
| Lo que lo reduce | Un sitio alterno listo, procedimientos escritos y automatización. | Copias más frecuentes o réplica continua. |
| Quién lo siente primero | Las áreas que no pueden trabajar mientras el sistema está caído. | Las áreas que tienen que volver a capturar lo que se perdió. |
Un sistema puede tener un RTO corto y un RPO largo, o al revés. Un sitio web informativo tolera perder la última semana de cambios, pero no estar caído días. Una base de datos contable puede esperar unas horas para volver, pero no perder una sola póliza. Ambos números se fijan dentro del plan de recuperación ante desastres (DRP), junto con el orden en que se recupera cada sistema.
Ejemplos de RTO y RPO por sistema
No hay números correctos para todas las empresas, pero sí rangos habituales. Estos son puntos de partida que cada organización ajusta según lo que pierde con cada hora:
| Sistema | RTO habitual | RPO habitual | Qué lo cubre |
|---|---|---|---|
| Tienda en línea | 30 minutos | 5 minutos | Réplica continua y un ambiente alterno listo para encender. |
| ERP y facturación | 2 horas | 30 minutos | Réplica continua o respaldos muy frecuentes. |
| Correo y colaboración | 4 horas | 4 horas | Respaldo en la nube varias veces al día. |
| Carpetas compartidas | 8 horas | 12 horas | Respaldo dos veces al día. |
| Sitio web informativo | 1 día | 1 semana | Respaldo semanal y un plan para volver a publicarlo. |
Hay un detalle que cambia el RPO real frente a un ataque. Si el ransomware cifró los archivos días antes de que alguien lo notara, las copias más recientes también están dañadas y el punto de recuperación útil es anterior. Por eso conviene poder volver a un momento específico, no solo a la última copia; cómo opera ese ataque lo explicamos en qué es el ransomware.
Cómo calcular cuánto cuesta cada hora sin sistema
El RTO correcto sale de una cuenta sencilla: cuánto pierdes por cada hora detenido. Con ese número, dirección puede comparar el costo de la solución contra el costo de esperar. Así se calcula para una comercializadora que factura 30 millones de pesos al mes y cuyo ERP detiene la venta cuando falla:
- Ventas que dependen del sistema. 30 millones entre 22 días hábiles y 10 horas de operación: unos 136,000 pesos por hora.
- Personal que no puede trabajar. 40 colaboradores con un costo de 250 pesos por hora cada uno: 10,000 pesos por hora.
- Costos de recuperación y penalizaciones. Horas extra para recapturar, entregas atrasadas y multas de contratos: unos 20,000 pesos por hora.
- Total. Alrededor de 166,000 pesos por cada hora sin el ERP.
Con ese número, un RTO de ocho horas representa 1.3 millones de pesos por incidente; uno de una hora, 166,000. La diferencia es el presupuesto que razonablemente se puede invertir para acortar la recuperación. Algunas ventas se recuperan después, así que conviene ajustar el primer renglón con el área comercial.
A escala global, la encuesta de ITIC de 2024 encontró que para más del 90% de las empresas medianas y grandes una hora de inactividad cuesta más de 300,000 dólares.
Si el paro lo provoca un ataque, se suman otros costos, que desglosamos en cuánto cuesta un ataque de ransomware.
Cómo reducir el RTO y el RPO
Volviendo al videojuego: guardar más seguido y tener la consola lista son dos mejoras distintas. En una empresa, cada objetivo se ataca con sus propias medidas.
Para bajar el RPO:
- Respaldar con más frecuencia los sistemas críticos, no todo con la misma regla.
- Replicar de forma continua los servidores que no toleran perder minutos de información.
- Guardar una copia fuera del sitio principal y protegida contra el borrado.
- Conservar varios puntos de recuperación, para volver a un momento previo a un cifrado o a un error.
Para bajar el RTO:
- Tener un sitio alterno ya preparado en la nube, en lugar de conseguir equipo el día de la falla. Así funciona la recuperación ante desastres como servicio.
- Escribir el procedimiento de recuperación paso a paso, con responsables y orden de arranque.
- Automatizar el encendido de los sistemas en el sitio alterno.
- Recuperar primero lo que más cuesta por hora, según el cálculo anterior.
El RTO en papel vs el RTO real
Un RTO escrito en un documento no garantiza nada hasta que se prueba. Estas son las tres suposiciones que más a menudo resultan falsas el día del incidente:
| Lo que dice el papel | Lo que pasa en la práctica |
|---|---|
| "Tenemos respaldo, así que volvemos en unas horas." | Restaurar varios servidores desde un respaldo puede tomar días; el respaldo protege la información, no el tiempo. |
| "Respaldamos cada noche, así que el RPO es de 24 horas." | Si el respaldo de anoche falló o se cifró, el RPO real es el de la última copia buena, que puede ser de hace una semana. |
| "Lo probamos cuando se instaló." | Desde entonces cambiaron servidores, aplicaciones y personas. Sin una prueba al año, el número es una esperanza. |
La prueba de recuperación convierte el objetivo en un dato: mide cuánto tarda de verdad cada sistema en volver y si la información está completa. Esa diferencia entre la meta y lo que realmente tardas es la misma que separa al RTO del MTTR, una de las métricas MTTD, MTTA y MTTR con las que se evalúa la respuesta a incidentes.
Preguntas frecuentes sobre RTO y RPO
Son siglas en inglés. RTO es Recovery Time Objective, el tiempo que un sistema puede estar detenido. RPO es Recovery Point Objective, la información que se puede perder, contada en tiempo desde la última copia. Juntas definen qué tan rápido y hasta qué punto se recupera cada sistema.
El MTD (Maximum Tolerable Downtime, tiempo máximo tolerable de interrupción) es el límite a partir del cual el daño al negocio es irreversible. El RTO siempre debe ser menor que el MTD, para dejar margen a verificar que el sistema funciona antes de volver a operar.
Casi: con dos sitios activos al mismo tiempo que se replican en tiempo real, la pérdida y la espera se acercan a cero. Es una arquitectura cara que solo se justifica en sistemas donde cada minuto cuesta mucho, como pagos o comercio en línea de alto volumen.
El dueño de cada proceso dice cuánto tiempo y cuánta información puede perder su área; TI dice qué tecnología hace falta para cumplirlo y cuánto cuesta; y dirección aprueba el equilibrio entre ambos.
Sí, porque permite respaldar con más frecuencia sin depender de cintas o discos locales. Un servicio gestionado, como nuestras copias de seguridad en la nube, además monitorea que cada respaldo se complete.
Al menos una vez al año, junto con la prueba de recuperación, y siempre que cambie algo importante: un sistema nuevo, una migración a la nube o un proceso que se vuelve crítico para las ventas.

Zoilijee es Fundadora y KAM de TecnetOne, se especializa en desarrollo de negocios para entornos Cloud, Híbridos y Ciberresiliencia Empresarial, su visión principal es lograr capacitar y proteger a las organizaciones sobre las nuevas amenazas emergentes en TI. Con una sólida formación en Informática, ha impulsado el desarrollo de negocios tecnológicos de alto impacto para empresas de todos los sectores.